Что значит LLMs в названии и кто придумал формат
LLMs — large language models, большие языковые модели вроде тех, что работают в ChatGPT, Claude или Алисе AI, и формат придуман для них и для агентов на их основе. Агент здесь — программа на базе модели, которая сама ходит по сайтам и выполняет задачу пользователя: ищет ответ, читает инструкцию, сравнивает условия.
Предложил llms.txt Джереми Говард, сооснователь компании Answer.AI, 3 сентября 2024 года. Его довод такой: страницы сайтов сделаны для людей — меню, баннеры, скрипты, а полезное содержание где-то посередине. Модели приходится всё это разбирать, а её окно контекста, то есть сколько слов она способна учесть за один раз, ограничено, и целый сайт в него обычно не помещается. Короткий файл с выжимкой и ссылками экономит ей эту работу.
В августе 2026 года вышла вторая версия предложения. Она уточнила, как работает файл в разделе сайта: /docs/llms.txt описывает всё, что лежит в /docs/, а если подходят несколько файлов, агент берёт ближайший по пути. Ещё она предложила связывать страницу с её Markdown-копией и с нужным llms.txt стандартными ссылками rel="alternate" и rel="describedby". Официальным стандартом формат так и не стал: это открытое предложение с репозиторием на GitHub, где его обсуждают все желающие.
Структура файла: обычный txt с разметкой Markdown
Файл состоит из нескольких блоков в строгом порядке, и обязателен из них только первый — заголовок с названием сайта. Markdown — простая разметка обычного текста: решётка в начале строки делает строку заголовком, угловая скобка — цитатой, а запись [название](адрес) — ссылкой.
-
Заголовок первого уровня —
# Название, имя проекта или сайта. Единственный обязательный элемент. -
Цитата с кратким описанием — строка
> …: ключевые сведения, без которых остальной файл не понять. - Подробности без заголовков — абзацы и списки о том, как устроен проект и как читать ссылки ниже.
-
Разделы второго уровня —
## Услуги,## Документацияи любые другие. Внутри — список ссылок вида- [Название](адрес): пояснение, пояснение после двоеточия необязательно. -
Раздел
## Optional— ссылки второго плана, которые агент может пропустить, когда места в контексте мало.
Встречается совет не переводить заголовок Optional, потому что агент узнаёт раздел только по этому слову. Совет тянется из первой версии, где у раздела был служебный смысл для утилиты, разворачивавшей файл в один большой контекст. Во второй редакции утилиту из предложения убрали, и Optional остался просто договорённостью о второстепенных ссылках.
Рядом с llms.txt часто называют llms-full.txt — один большой файл с полным содержимым всех страниц справочника. В спецификации его нет: такие файлы генерируют платформы документации, например Mintlify. Для справочника по программе, который агент загружает целиком, это удобно. У сайта услуг склеивать в один файл нечего, и смысла в нём я не вижу.
Что про llms.txt говорят Google, Яндекс и ИИ-компании
Google о llms.txt высказался прямо: его поиску файл не нужен. В справке Яндекса позиции по файлу нет, а OpenAI, Anthropic и Perplexity в описаниях своих ботов не говорят, что те его читают.
В руководстве по оптимизации под генеративный поиск файл назван по имени: поиск llms.txt и похожие файлы не использует, поэтому видимости и позициям файл не поможет и не навредит. Держать его для других сервисов, которые такие файлы читают, по тому же руководству, нормально.
В соседнем руководстве, об ИИ-функциях поиска — AI Overviews и AI Mode, — сказано: чтобы в них появиться, не нужно создавать новые машиночитаемые файлы, текстовые файлы для ИИ или разметку, и специальные данные schema.org тоже не нужны. Условие то же, что и для обычной выдачи: страница в индексе и может показываться со сниппетом — фрагментом текста под заголовком результата. Из советов там же — не закрывать обход в robots.txt и отдавать важное содержимое текстом.
Ещё llms.txt упоминает Lighthouse — инструмент той же компании для проверки страниц. Среди его проверок для ИИ-агентов есть пункт про этот файл, и устроен он мягко: ошибкой считается только сбой сервера при попытке получить файл. Если файла нет и сервер отвечает 404, проверка помечается как неприменимая, потому что файл, как сказано в её описании, пока необязателен.
Яндекс про llms.txt молчит. Я скачал полный текст справки Вебмастера — Яндекс отдаёт его одним файлом — и поискал в нём «llms»: ни одного совпадения на 26 октября 2026 года. Любопытно, что справка Яндекса и сделана по этому формату: у неё есть свой llms.txt со списком страниц, а у страниц — Markdown-копии со ссылкой rel="describedby" на этот список. Для своей справки Яндекс формат использует, а владельцам сайтов о нём ничего не пишет.
О генеративных ответах Яндекс говорит другое: раз ответы Алисы AI строятся с опорой на поисковую выдачу, «принципиально новых требований не возникает». Алиса AI, по справке, опирается на самые релевантные, информативные и качественные страницы, которые обычно стоят высоко в выдаче.
У ИИ-компаний картина похожая. OpenAI, Anthropic и Perplexity подробно описывают своих краулеров (это программы, которые обходят сайты): как их зовут, зачем нужен каждый и как его закрыть. Читают ли эти боты llms.txt на сайтах, там не сказано. Сам файл разработчики моделей держат у своих справок: у OpenAI и Perplexity в начале страниц о ботах стоит даже служебная ссылка на llms.txt их документации, есть файл и у документации Claude, и у документации Gemini API. Это подспорье для программистов, которые подключают модели к своим программам, а не обещание, что боты этих компаний открывают такие файлы на чужих сайтах.
Читают ли llms.txt ИИ-боты: логи трёх сайтов
На трёх сайтах из выборки — нет. За 15 дней ИИ-боты обратились к трём сайтам 6 600 раз и сотни раз открыли robots.txt, но среди этих запросов нет ни одного к /llms.txt.
Сколько раз ИИ-боты заходили на сайты
Логи — журнал, куда сервер записывает каждый запрос: время, адрес, код ответа и строку User-Agent, которой посетитель представляется. Я взял логи nginx трёх сайтов разной тематики за 12–26 октября 2026 года: 15 дней и 105 894 запроса. Кто есть кто, я определял по User-Agent, без проверки IP-адресов, поэтому часть «ботов» может оказаться подделкой. Googlebot и YandexBot стоят в таблице для сравнения.
| Бот | Чей и зачем | Обращений к сайтам | Из них к robots.txt |
|---|---|---|---|
| PerplexityBot | Perplexity, ответы с поиском | 1 529 | 71 |
| ClaudeBot | Anthropic, данные для обучения моделей | 1 200 | 380 |
| OAI-SearchBot | OpenAI, ответы ChatGPT с поиском | 499 | 150 |
| Applebot | Apple, поиск в Siri, Spotlight и Safari | 38 | 11 |
| Googlebot | Google, обход для выдачи | 2 352 | 303 |
| YandexBot | Яндекс, обход для выдачи | 226 | 25 |
Остальные ИИ-боты за те же дни: Bytespider (ByteDance) — 651 обращение, Amazonbot — 627, meta-externalagent (Meta) — 595, GoogleOther, общий сборщик для исследований, — 495, ChatGPT-User — 316, GPTBot — 299, CCBot (Common Crawl) — 286. Ещё 65 обращений пришлись на шесть редких сборщиков: Perplexity-User, Google-CloudVertexBot, cohere-ai, Claude-User, DuckAssistBot и Claude-SearchBot. ClaudeBot открывал robots.txt в среднем 25 раз в день на три сайта, OAI-SearchBot — 10: правила доступа эти боты перечитывают постоянно.
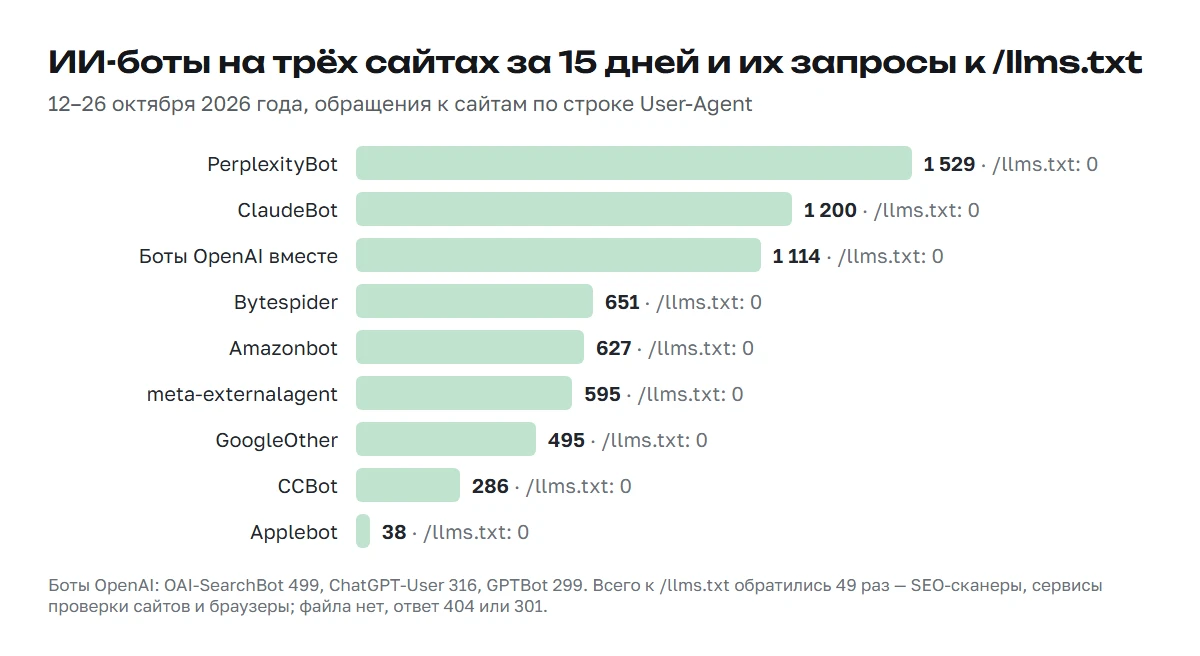 Логи nginx трёх сайтов · 12–26.10.2026
Увеличить
Кто спрашивал /llms.txt
За те же 15 дней адрес /llms.txt на трёх сайтах запросили 49 раз — меньше пяти сотых процента всех запросов, и ни один не пришёл от ИИ-бота. Не спрашивали файл и роботы поисковиков — Googlebot и YandexBot.
Файл искали программы для проверки сайтов. SEOJuice-SearchBot, бот SEO-сервиса, сделал 13 запросов, все — к одному из трёх сайтов. Ещё 8 пришли от HeadlessChrome — браузера без окна, на котором запускают автоматические проверки, и 3 — от сканеров «SEO-Audit/1.0» и «SEO-Audit/2.0». Остальные запросы пришли с User-Agent обычных браузеров, от сервиса BuiltWith и бота мониторинга DropMonBot. На этих сайтах llms.txt интересовал программы для аудита, а не нейросети. Ответ во всех 49 случаях — 404 или переадресация на защищённую версию адреса: файла нет ни на одном из трёх сайтов, это я проверил прямо в папках сайтов.
Нужен ли llms.txt вашему сайту
Нужен, если у вас документация к программе, API или база знаний, с которой работают разработчики и их ИИ-помощники; сайту услуг он почти ничего не даёт, хотя и не мешает.
Прочнее всего формат прижился в справочниках по программам — так пишет и автор предложения: агенты для программирования идут по llms.txt к справочникам по API и руководствам. Платформы документации генерируют файл автоматически, а крупные компании выкладывают его для своих справок — от OpenAI до Яндекса. Для обычных сайтов файл умеют делать плагины WordPress Yoast SEO и AIOSEO, а конструктор Wix создаёт его для каждого сайта на своей платформе.
С сайтом услуг иначе. Агенту нетрудно прочитать два десятка страниц и без путеводителя, а ИИ-ботов, которые бы этот путеводитель запрашивали, в этих логах нет. Связь между файлом и цитированием в ответах нейросетей не подтверждает ни один документ, который я прочитал, — ни у поисковиков, ни у ИИ-компаний. Поэтому с сайтом услуг я начинаю не с llms.txt, а с другого: открытый доступ для краулеров, содержание страниц в HTML, понятная первая фраза у каждого раздела.
Интернет-магазину файл тоже мало что добавит: тысячи товаров в путеводитель не поместятся, а категории, доставку и оплату можно перечислить, но читает ли кто-то такой файл, покажут только логи. Если основа уже в порядке и хочется проверить формат на практике, файл можно добавить: работы на полчаса, а вреда от аккуратного файла я не вижу. Только относитесь к этому как к опыту с проверкой по логам через месяц-другой, а не как к способу попасть в ответы ИИ.
Как создать llms.txt для сайта услуг: пример и проверка
Создать файл можно в любом текстовом редакторе вручную: отобрать 10–20 главных страниц, написать к каждой одну строку пояснения, сохранить в кодировке UTF-8 под именем llms.txt и разместить в корневой папке сайта. Если сайт сделан с ИИ-агентом, это можно поручить ему одной задачей — как и другие правки, о которых я пишу в статье про вайбкодинг сайта.
Пример файла для мастерской
Так мог бы выглядеть файл небольшой мастерской по ремонту техники. Адрес example.com условный.
| Строка файла | Зачем она |
|---|---|
# Мастерская «Пример»
|
Название — единственная обязательная строка |
> Ремонт стиральных и посудомоечных машин на дому в Казани, выезд мастера в день заявки.
|
Кто, что и где — сведения, которые модель должна знать в первую очередь |
Цены на сайте указаны за работу, запчасти считаются отдельно.
|
Пояснение, без которого страницы легко понять неправильно |
## Услуги
|
Первый раздел со ссылками |
- [Ремонт стиральных машин](https://example.com/stiralnye/): поломки, сроки, что входит в выезд
|
Ссылка и ответ на вопрос «что на странице» |
- [Ремонт посудомоечных машин](https://example.com/posudomoechnye/): марки и типичные неисправности
|
Вторая услуга в том же формате |
## Компания
|
Раздел с условиями и контактами |
- [Цены](https://example.com/ceny/): стоимость работ по видам ремонта
|
Страница, о которой чаще всего спрашивают |
- [Контакты](https://example.com/kontakty/): адрес, телефон, часы работы, районы выезда
|
Где и когда работает мастерская |
## Optional
|
Второстепенное, что можно пропустить |
- [Статьи](https://example.com/blog/): советы по уходу за техникой
|
Блог, без которого назначение сайта понятно |
Порядок действий
- Берите страницы, которые отвечают на вопросы клиентов: услуги, цены, условия, контакты, «О компании». Корзина, поиск по сайту, фильтры, дубли и страницы, которые скоро удалите, в файл не идут.
- Пишите пояснение так, чтобы из него было понятно назначение страницы. Подписи «подробнее» и «перейти» ничего не объясняют, рекламное «сервис номер один» тоже.
- Адреса делайте полными, с протоколом и тем вариантом домена, который у сайта главный, — с www или без.
- Разместите файл в корне, рядом с robots.txt, и откройте ваш-сайт.ru/llms.txt в браузере.
- Проверьте заголовки ответа командой
curl -I https://ваш-сайт.ru/llms.txt: нужен код 200 и тип содержимого text/plain или text/markdown — так файлы отдают, например, документация OpenAI и Gemini. Если в ответе text/html, сервер, скорее всего, отдаёт вместо файла страницу «не найдено». - Меняйте файл вместе с сайтом: новая услуга, смена адресов, удалённый раздел — правка в llms.txt в тот же день.
Спецификация советует вести ссылки на Markdown-копии страниц — тот же адрес с .md на конце или с .md вместо расширения. Для сайта услуг это лишняя работа: если содержание страницы есть в HTML, я бы ссылался на обычные адреса.
Генератор или вручную
Генератор llms.txt ускорит работу на большом сайте, но результат стоит перечитать: какие страницы для вашего бизнеса главные и как их коротко подписать, лучше решить самому.
Если разместить файл некому или хочется, чтобы он обновлялся вместе с сайтом, это задача из доработки сайта с ИИ: такую правку я вношу сам и сразу проверяю, что файл отдаётся с кодом 200. Почему я берусь за внедрение, а не только пишу задания разработчику, — в разборе о правках, которые некому внедрить.
llms.txt, robots.txt и sitemap.xml: что чем управляет
Доступом роботов к сайту управляет robots.txt, список страниц для индексации даёт sitemap.xml, а llms.txt ничего не разрешает и не запрещает — он только описывает сайт.
| Файл | Что делает | Кто его открывает |
|---|---|---|
| robots.txt | Разрешает или запрещает обход разделов конкретным роботам | Поисковые роботы и краулеры ИИ-компаний |
| sitemap.xml | Перечисляет страницы, которые стоит проиндексировать | Поисковые системы |
| llms.txt | Коротко описывает сайт и ведёт к главным страницам | Агенты — если решат его открыть |
Как закрыть сайт от конкретного ИИ-бота
Чтобы закрыть сайт или раздел от конкретного ИИ-бота, нужна группа правил с его именем. Имена и последствия ниже — из описаний, которые публикуют сами компании.
| Что ограничить | Имя робота | Что изменится |
|---|---|---|
| Обучение моделей OpenAI |
GPTBot
|
Материалы сайта не будут использоваться для обучения базовых моделей |
| Ссылки в ответах ChatGPT |
OAI-SearchBot
|
Сайт не покажут в ответах ChatGPT с поиском, хотя навигационной ссылкой он появиться может |
| Обучение Claude |
ClaudeBot
|
Новые материалы сайта исключат из обучающих данных |
| Поисковые ответы Claude |
Claude-SearchBot
|
Страницы не попадут в индекс, по которому ищет Claude |
| Выдача Perplexity |
PerplexityBot
|
Сайт может пропасть из результатов Perplexity: чтобы в них появляться, компания советует бота не закрывать |
| Обучение Gemini и grounding — подстановку свежих данных из поискового индекса в ответ модели |
Google-Extended
|
На обычную выдачу и позиции не влияет |
| Ответы Алисы AI |
YandexAdditionalBot
|
Информация с сайта перестанет показываться в ответах Алисы AI |
Две оговорки. Первая: обращения, которые бот делает по просьбе пользователя, устроены иначе. OpenAI пишет, что для ChatGPT-User правила для роботов могут не применяться, Perplexity — что Perplexity-User их обычно игнорирует, а Anthropic такие запросы позволяет закрыть отдельной группой для Claude-User.
Вторая: отдельного сборщика у AI Overviews и AI Mode нет. По объяснению компании, ИИ встроен в поиск, поэтому доступ задают правила для Googlebot, а показ фрагментов страниц — метки nosnippet, data-nosnippet, max-snippet и noindex.
Что проверить на своём сайте вместо llms.txt
Проверьте три вещи, которые скажут о вашем сайте больше любого llms.txt: настройки доступа, логи и то, есть ли текст страниц в HTML.
-
Правила доступа. Откройте ваш-сайт.ru/robots.txt и поищите группы для GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot, Google-Extended и YandexAdditionalBot. Если отдельных групп нет, действует общая группа
User-agent: *, а у роботов Яндекса — ещё и группаUser-agent: Yandex, если она есть: она важнее общей. Google-Extended и YandexAdditionalBot сами по сайту не ходят: это метки в robots.txt, которыми вы решаете, можно ли брать для ИИ страницы, уже скачанные поисковым роботом. За обучение и за поисковые ответы у компаний работают разные сборщики, так что решение можно принять для каждого отдельно. -
Логи. Попросите разработчика или хостинг выгрузить обращения к /llms.txt и /robots.txt за две недели и разложить их по тому, кто их сделал. На nginx с ротацией логов это одна команда:
zgrep -h "/llms.txt" /var/log/nginx/access.log*. Так вы увидите, кто спрашивает файл у вас, а не в чужой статистике. - Содержание в HTML. Откройте исходный код важной страницы сочетанием Ctrl+U и проверьте, есть ли в нём описание услуги. Что есть в исходном коде, получит любой краулер, даже тот, что не выполняет скрипты.
Если по логам окажется, что ваш llms.txt кто-то регулярно спрашивает, файл стоит держать в порядке. Если нет — время разумнее отдать страницам, которые поисковики и ИИ-боты и так открывают каждый день.